 chuck.
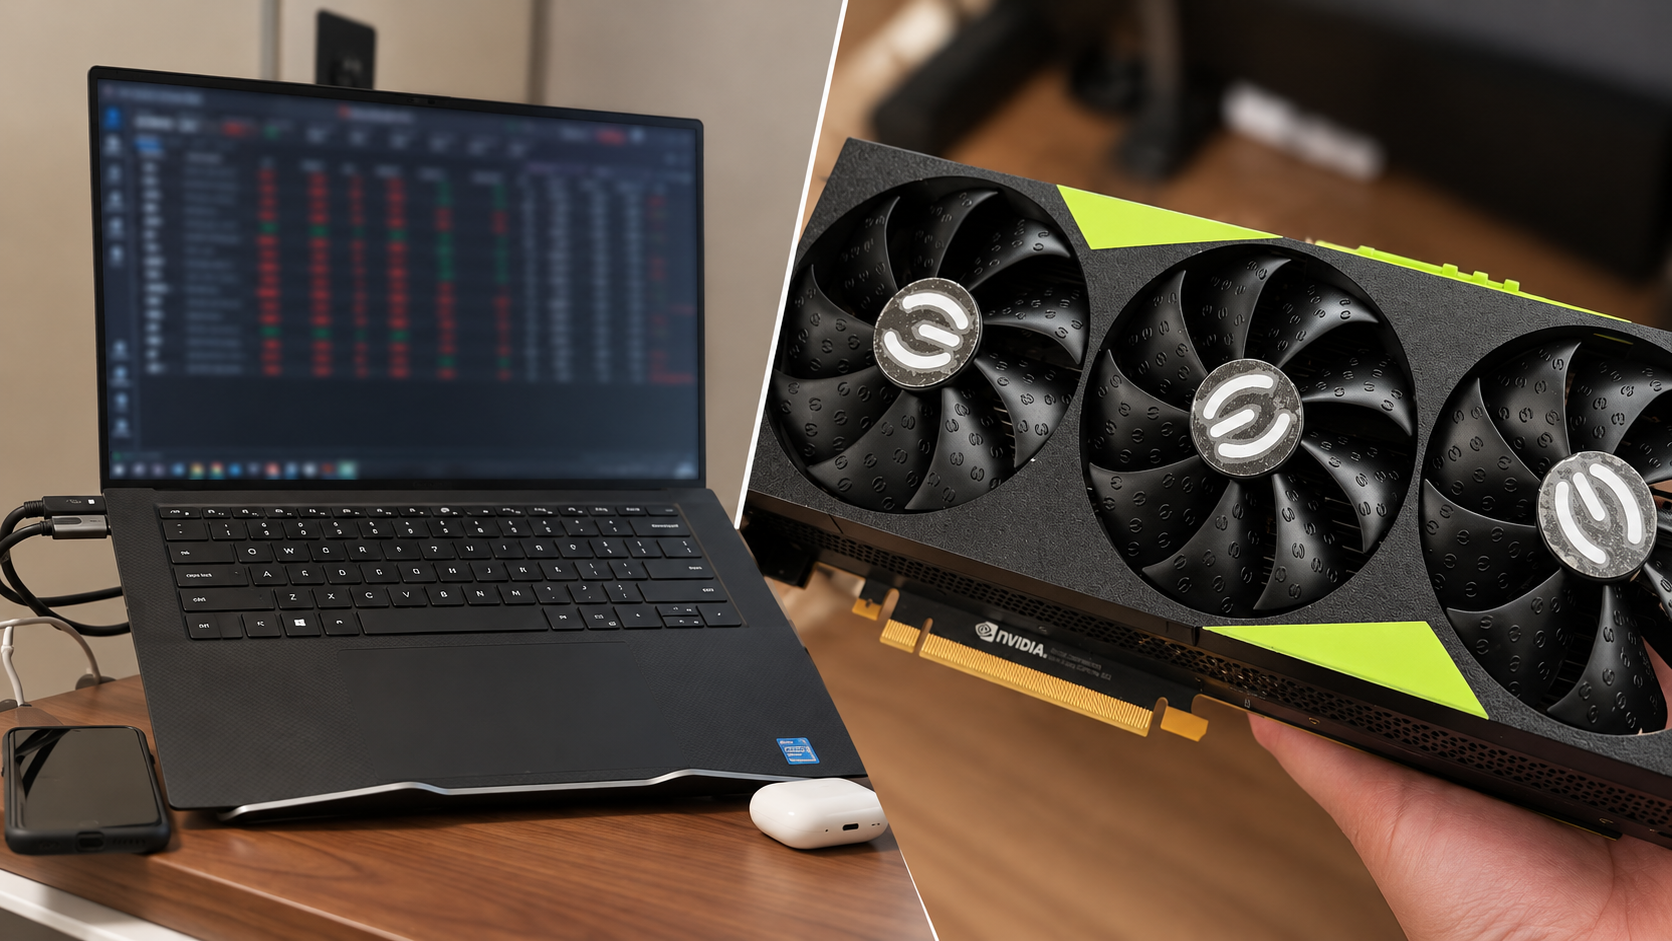
我开始折腾本地 AI,用的是一台二手笔记本。
后来接了外置显卡坞,又买了 V100。设备是这样一件件加上来的。我没有编程背景,也没有一开始就给自己配出一套完整的 AI 工作站。先有想做的事,再看看手里的电脑能不能做,不够的地方再补。
转写、翻译、整理长文件,都是我平时会碰到的工作。有些材料要留在本机,我就让 Codex 帮我接本地模型。最初能问一句话、得到一段回答,已经让我觉得这套设备没有白折腾。
等工具多起来,问题却开始出在模型回答之外。哪个程序正占着显卡,刚才的任务还在不在跑,下一件事什么时候轮到,越来越需要我自己盯着。
我先做了一个看显卡的小工具
接上 V100 以后,我想随时知道它有没有连着,温度怎么样,显存用了多少。每次都去敲命令查一遍,不是我想长期用的方式。
于是做了一个 Windows 托盘监测器,放在右下角。右键点开,能看温度、利用率、显存、功耗这些指标。图标也得像一块显卡,我让它用了带双风扇轮廓的样子,免得混在一排小图标里认不出来。
第一版没有主窗口,我还遇到过“打不开”的误会。程序其实已经在托盘里运行,只是没有弹出一个大窗口,双击以后看不出发生了什么。
后来补了启动通知,重复打开也提醒已经在运行。这个小修改,比给界面多加一排指标更有用。我得先找得到它,才谈得上去看显卡。
当时还只是一个监测器。我没想到,后面它会连任务排队也一并管起来。
两个入口,看的却差不多
到了九月中旬,我已经在用 Qwen 的 27B 本地模型。另一边,转写、翻译和文本处理也逐渐有了自己的入口。模型中心能看模型和任务,显卡监测器能看硬件。
可我打开它们以后,发现很多功能都是重复的。想知道电脑现在在忙什么,反而要分别看两处。
我当时的要求很直接:肯定要合并,这些东西没有必要各开一个入口。
后来保留了 V100 的托盘前台,让模型中心在后台工作。一个地方可以看硬件,也能看模型状态、任务队列,启动或停止模型。电脑里仍然有不同的程序在做事,但我不必为了查一次状态,在它们之间来回找。
这套分工也是用出来的。没有哪个步骤让我突然懂了软件架构,我只是知道两个差不多的窗口放在桌上,会让我觉得多余。
主力显卡只有一块,任务却越来越多
一个工具单独用的时候,选文件,等结果,往往就够了。几个入口都接上以后,就开始互相碰到。
转写还没做完,我又想翻译。长材料正在整理,另一个对话也会向本地模型发任务。每个入口都觉得自己可以开始,显存和模型却没有凭空多出几份。
我需要让这些活走到同一个地方。任务先交给模型中心,中心记住它们,按顺序处理。队列得保存在电脑里,关掉一个窗口,不应该让里面的活跟着消失。
队列有了以后,我很快又提了一个要求:顺序我要能改。
我当时说过,我自己有能力判断哪个任务更紧急。有的可以慢慢跑,有的结果马上就要用。我要能把任务往前拖,设成下一项,取消,或者重新排队。
“立即执行”也不能只是把正在做的事扔掉。已经完成的部分怎么留住,打断的任务怎么接着来,都得有交代。
我越来越发现,软件的要求常常是前一个功能做出来以后,后一个才说得清。没有队列的时候,我只会觉得电脑忙得不透明;有了队列,我才开始认真想自己要怎样安排它。
我明明关掉了 LM Studio,它又自己起来了
整合里有一次小问题,我到现在还记得。
我不想让 LM Studio 一直常驻,需要用的时候自己打开就行。可明明关掉了它,过一阵又能看到它起来。
最后查到,是监测器在检查它有没有运行。为了查状态,程序去调用 LM Studio 的命令行工具;这个动作反而把软件叫醒了。
本来想知道一个程序开没开,结果负责检查的程序替我把它打开了。
修复以后,先看 LM Studio 的进程是不是已经存在。存在,才去读它的模型状态;不存在,就写“LM Studio 未运行”,不要再去碰它。
模型有没有更聪明,和这个问题没有关系。对我来说,一个后台工具肯不肯安静待着,直接决定我愿不愿意把它留在电脑里。
腾出显存之后,下次又得等
模型越用越大,我也开始碰到一个以前没想过的取舍:空闲时该不该把它卸掉。
九月的一次检查里,27B 模型闲了三分半,仍然占着大约 27GB 显存。对一块 32GB 的 V100 来说,这是很大一块地方。别的工具要用显卡,我当然希望它能让出来。
但卸掉以后,下一次再叫它做事,又得把模型加载回来。当时测到的一次冷加载,大约要二十秒。
我以为把显存腾出来就好了,结果下一次问它,又要等。后来再看“没有回应”,就不能只盯着生成速度:它可能在排队,也可能正在加载,还可能是真的出错。
状态得说清楚,我才能决定是继续等,还是换个安排。一个转圈的动画,对这些情况给不出什么帮助。
我把长任务改成了先领一个号码
另一个麻烦,是长任务把对话卡住。
一大份材料交给本地模型,如果整条请求一直等到处理结束,我就得守着它。等得久,还可能超时。材料有没有送进去,后台有没有开始,没返回的时候都很难判断。
后来改成异步提交。先把任务交进去,拿到一个编号,接着可以干别的。回来查这个编号,就知道它在排队、处理中,还是已经有了结果。
结果保存成文件,失败也要有明确的状态。不能一条请求没回来,已经做过的东西就跟着找不到。
这看起来像技术上换了一种调用方式,给我的感觉却很简单:原来是站在旁边一直等,现在先把活交出去,拿着号再来取。
长文件塞进去,模型也会拒收
用久了,还得给材料和输出设限。
九月二十五日,我们对 325 条历史记录做过一次检查。其中有三次请求,输入太长,直接被服务拒绝,没有拿到任何产出。还有十次,输出从中间被截断了。
不是每次显示处理完成,我就真的拿到了整份结果。
后来定下规矩:长材料先检索、压缩或者拆开,不再整包塞。先告诉它这次要哪几列、每一格放什么,再让它填固定的表格或 JSON,不让它自己决定整份结果怎么写。输出也要分块,长表格不能指望一单从头写到尾。
我还试过让本地模型写一篇规定长度的文章。要求六百到八百字,交回来的是一千一百八十九字。文字看起来挺顺,可我的要求没守住。
后来我更愿意让它做重复的事:翻译、校对、从材料里提事实。一格一个值,数字和原文位置留着,我更容易检查。至于该怎样判断、哪些内容值得写,以及最终文章的语气,还是要由我和主助手继续处理。
模型会写字,和它适不适合接某一类活,是两件事。把它放到合适的位置,比每次都让它多做一点更省事。
后来,模型换了,排队这件事留下了
最近,我又在给这套模型中心接 Qwen3.8-Flash-Next 125B,用来运行模型的程序换成了 Strata。它负责需要时把模型加载起来。新的路线还要继续拿实际任务试:服务有了回应,接下来的文件有没有处理完、结果能不能拿来用,还得一项项检查。125B 这个数字本身,不会替我解决等候、显存和结果完整性的问题。
我不想让整个系统跟着某一个模型名字走。将来换模型,提交任务、查看队列、调顺序和保存结果这些习惯,还应该留得下来。
从二手笔记本、外置显卡坞和 V100 开始,我最初只是想在自己的电脑上处理几件事。后来竟然给它做了监测器、模型中心、队列和几套工作规矩。
我到现在也不会从零独立写出它们。AI 帮我把程序做出来,我负责在每天使用的时候发现问题:为什么有两个入口,为什么关掉的程序又起来,为什么一项活卡住后不知道发生了什么。
这些小问题没有哪一个特别像科技新闻里的大突破,却都关系到我明天还愿不愿意再打开它。
我更喜欢按这样的顺序继续做下去:先有一件要完成的事,做一个能试的版本,用起来,再把刚刚冒出来的要求加进去。设备是慢慢买的,软件也可以慢慢长。